在传统 AI 辅助开发中,最大的硬伤就是“数据失真”:你让 AI 写测试用例,它靠天马行空的想象编了一堆过于规整的 test_user_01、123456,看起来单测全绿,一到线上遇到用户真实上传的复杂简历、生僻字符和奇葩业务状态,新功能立刻崩溃。DBHub 的出现,就是为了打破“假数据测试”的死局,让大模型直接站在真实数据的土地上。
通过 DBHub,AI 智能体不再是一个只能看代码文本的盲人,而是具备了只读探测真实数据库底层事实的“透视眼”。用存量业务样本做回归,用一手统计数据做汇报,每一次分析和交付都扎扎实实、有据可查。
什么是 DBHub:赋予 AI 数据库只读超能力
Bytebase 开源的数据库网关与 MCP 服务,为 AI 智能体打通安全访问多源数据库的标准管道。
DBHub(来自知名数据库 DevOps 团队 Bytebase)是专门为现代开发者和 AI 智能体打造的轻量级通用数据库中继与 MCP(Model Context Protocol)网关:
工业级配置:npx 零安装与 dbhub.toml 脱敏实战
参考生产级最佳实践:opencode.json 声明 MCP 服务 + dbhub.toml 环境变量安全脱敏。
在严肃的企业级软件工程中,直接把数据库密码明文写在代码或配置里是严重的事故隐患。推荐采用工业级标准配置范式:利用 opencode.json 声明 MCP 本地命令,通过 npx -y @bytebase/dbhub@latest 实现免全局安装,配合 dbhub.toml 完成全链路环境变量注入与安全脱敏。
在 opencode.json 中声明 DBHub MCP 服务
在项目根目录的 opencode.json 配置文件中,将 DBHub 声明为本地 MCP 工具,指向同级目录的 ./dbhub.toml:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "dbhub": {
      "type": "local",
      "command": ["npx", "-y", "@bytebase/dbhub@latest", "--config", "./dbhub.toml"],
      "enabled": true
    }
  }
}编写 dbhub.toml:环境变量脱敏与多数据源契约
将数据库账密全部收敛到系统的 .env 或环境变量中,配置文件本身完全脱敏且安全可提交:
# dbhub.toml - 生产级脱敏配置

# 1. 业务主从只读库 (PostgreSQL / MySQL)
[[sources]]
id = "business_slave"
# 凭据完全来自环境变量,配置文件零硬编码
dsn = "postgres://${BIZ_DB_USER}:${BIZ_DB_PASS}@${BIZ_DB_HOST}:${BIZ_DB_PORT}/${BIZ_DB_NAME}"

# 2. 知识库/向量辅库 (可选开启懒加载)
[[sources]]
id = "knowledge_slave"
# lazy = true:启动时不强制校验连接,避免从库网络波动阻断整个服务启动
lazy = true
dsn = "postgres://${KB_DB_USER}:${KB_DB_PASS}@${KB_DB_HOST}:${KB_DB_PORT}/${KB_DB_NAME}"

# 声明向 AI 智能体暴露的 MCP 工具 (强制只读保护)
[[tools]]
name = "execute_sql"
source = "business_slave"
readonly = true   # 铁律:必须设为 true,防止 AI 误写或删除数据

[[tools]]
name = "search_objects"
source = "business_slave"

[[tools]]
name = "execute_sql"
source = "knowledge_slave"
readonly = true

[[tools]]
name = "search_objects"
source = "knowledge_slave"
1. 多 Source 工具自动命名规则:当配置多个 [[sources]] 时,DBHub 会自动在工具名后追加 _<source_id>(如暴露为 execute_sql_business_slave)。在客户端工具列表里找不到纯粹的 execute_sql 是正常机制,不是配置报错!
2. 只读防护边界:readonly = true 只能配置在 execute_sql 上,切勿滥用到其他自定义工具。
3. 变量插值严谨性:$${VAR} 如果在本地未 export,DBHub 会直接保留字面量,务必在启动前确保 .env 已正确加载。
实战一:从真实存量业务数据中精准采样,驱动高保真 QA 测试
摆脱 AI 凭空捏造数据的玩具测试!用真实复杂的简历与订单业务流,高精度验证新功能。
假设你在开发一个 HR 招聘管理系统,刚刚上线了一个崭新的功能模块:“简历解析与候选人画像重构”。按照常规流程:
初级做法:靠 AI 凭空假想构造用例
AI 自己脑补了一个叫“张三”、学历“计算机本科”、工作经历工整的 JSON 数据。结果测试一跑就过,上线后遇到真实候选人上传的图文混排 PDF、非标排版 Word、特殊字符薪资格式,解析流程当场崩溃。
工业级做法:让 AI 通过 DBHub 在真实存量库中采样验证
业务流程是有因果链条的:必须先有简历入库,才有后续的解析流程。现实中的存量简历千奇百怪,根本无法靠想象完全覆盖!这时指示 AI 通过 DBHub 采样 50 份不同年份、不同渠道(BOSS、猎聘、内推)的真实存量数据,将真实边界案例沉淀为 QA 测试用例,反复验证新功能在复杂极端情况下的韧性!
实战二:让 AI 直读数据库,做有据可查的数据分析与故障排查
深度挖掘表结构与活跃周期,秒级生成有图有真相的专业业务报表与根因诊断。
当 AI 具备直接读库能力后,日常研发和汇报的质感将发生质的改变:
汇报有据可查:物理事实支撑业务洞察
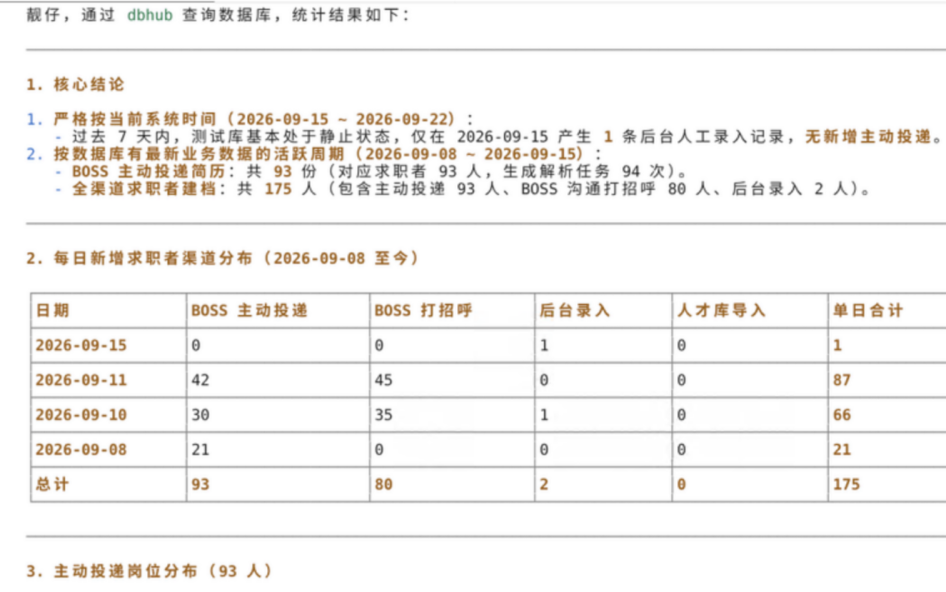
如上方实战截图所示,AI 连入数据库后,不仅能自动圈定业务活跃周期(例如 2026-09-08 ~ 2026-09-15),还能准确统计出 BOSS 主动投递 93 份、全渠道建档 175 人,并输出每日新增渠道分布表。你的工作汇报不再是“大概做完了”,而是拿数据说话、每一个数字都可追溯到数据库具体行号!
问题深入排查:直击数据库底层破损
线上遇到疑难 Bug(例如订单卡在“处理中”状态不推进),以往开发者需要找运维、要权限、敲 SQL、比对上下文。现在直接问 AI:“通过 dbhub 排查过去 2 小时未生成支付回调但订单状态为 PENDING 的异常记录”,智能体直接深入数据库定位脏数据与死锁原因。
实战提示词配方与工程落地规范
开箱即用的 Prompt 模板:从数据采样、用例入库到端到端 QA 闭环执行。
在你的终端智能体(如 OpenCode)中,可以直接使用以下标准提示词模板:
你现在是资深 QA 工程师兼架构师。请执行以下闭环任务:
1. 通过 dbhub 工具连接数据库,探查当前业务表结构;
2. 从真实存量数据中采样 20 条具备代表性、覆盖不同业务分支与边界情况的真实数据,严禁凭空捏造;
3. 将采样的真实用例转化为结构化测试用例文档,保存至 docs/qa/ 目录下;
4. 运行现有测试套件,使用采样的真实数据作为输入,执行端到端回归校验并输出断言报告。
• 开源代码仓库:https://github.com/bytebase/dbhub ↗
• TOML 配置规范指南:https://dbhub.ai/config/toml ↗
• Bytebase 官方生态:Bytebase 全球领先的 Database CI/CD 工具 ↗
AI 时代最危险的陷阱就是“自嗨式自动化”——用虚构的数据喂给虚构的测试,得到虚假的绿灯。通过 DBHub 将真实物理数据引入智能体循环,才能让 AI 真正成为替你扛起重任的生产力伙伴!